사업·마케팅 · 2026.10.21 · 7분
AI 답변 점수 1등, 길이를 따지자 6위로 내려갔다
긴 AI 답변이 채점에서 유리했지만 길이를 보정하자 순위가 바뀌었고, 전문가는 점수를 지키며 답을 줄였다.
고객 문의 답변을 AI에 맡기려고 몇 가지 모델을 시험해 보면, 대개 길고 꼼꼼하게 쓰는 쪽이 더 믿음직해 보입니다. 다른 AI에게 답변을 채점시켜도 비슷한 결과가 나옵니다. 그런데 그 점수에서 ‘길이’를 걷어 내면 순위가 크게 바뀐다는 측정 결과가 연달아 나왔습니다.
가장 높은 점수를 받은 답변이 길이를 따지자 6위로 내려갔습니다
AI 평가 기관 Artificial Analysis는 최근 HealthBench와 HealthBench Professional 순위표를 내놓았습니다. 둘 다 OpenAI가 만든 시험으로, 실제와 비슷한 건강 상담 대화에 AI가 답하면 의사들이 미리 써 둔 채점 기준표로 점수를 매깁니다. HealthBench는 일반 이용자와 보건 인력이 나눈 대화 5,000개, HealthBench Professional은 모두 임상의와 나눈 대화 525개로 이뤄져 있습니다.
이 기관은 두 가지 점수를 함께 공개했습니다. 하나는 기준표 항목을 얼마나 채웠는지 그대로 센 원점수이고, 다른 하나는 OpenAI 방식대로 2,000자를 넘는 답변은 깎고 짧은 답변은 올려 주는 길이 보정 점수입니다. 결과는 꽤 극적이었습니다. HealthBench Professional에서 Claude Opus 5.5는 원점수 71.4%로 가장 높았지만, 길이를 보정하자 59.9%로 떨어져 6위가 됐습니다. 이 모델과 Claude Fable 5.1은 답변 하나에 평균 약 5,900자를 썼는데, 기준선인 2,000자의 3배 가까운 분량이라 보정 뒤 11점 넘게 잃었습니다. 반대로 평균 약 1,600자로 유일하게 2,000자 아래였던 GPT-6 Sol은 보정 뒤 점수가 오른 유일한 모델이었습니다.
보정 점수 1위는 66.0%를 받은 GPT-6 Astra였습니다. 다만 비용까지 함께 보면 이야기가 또 달라집니다. GPT-6 Luna는 이 모델보다 4점 낮았지만 비용은 2%도 들지 않았습니다. 같은 일을 맡길 때 무엇을 기준으로 고르느냐에 따라 ‘가장 좋은 AI’가 바뀌는 셈입니다.
짧은 답은 읽기 쉽지만 빠뜨리는 것이 많았습니다
그렇다고 짧을수록 좋다는 결론도 아닙니다. HealthBench의 채점 항목은 정확성, 완전성, 소통 품질, 맥락 파악, 지시 따르기 다섯 갈래로 나뉩니다. 가장 짧게 쓴 GPT-6 Sol은 소통 품질 원점수가 81%로 가장 높았지만, 필요한 정보를 빠짐없이 담았는지 보는 완전성 점수는 34%로 가장 낮았습니다. 완전성 1위는 63%를 받은 Claude Sonnet 5.5였습니다. 길게 쓰면 빠뜨리는 것이 줄고, 짧게 쓰면 읽기 쉬워지는 맞교환이 숫자로 드러난 것입니다.
원래 HealthBench 논문도 이 문제를 직접 다뤘습니다. 연구진은 모델마다 같은 대화에 답변을 여러 개 만들게 한 뒤, 두 모델의 답변 길이가 10% 안쪽으로 비슷한 경우만 골라 다시 비교했습니다. o3는 GPT-4.1을 상대로 72.9%의 승률을 보였지만, 길이가 비슷한 답변끼리만 비교하면 63.7%로 줄었습니다. GPT-4.1과 o1의 비교에서는 아예 방향이 뒤집혀, 길이를 맞추지 않았을 때 61.0%였던 승률이 길이를 맞추자 65.2%가 됐습니다. 연구진은 최근 모델의 점수 상승이 더 자세한 답변 덕분이기도 하지만, 길이만으로는 설명되지 않는 부분도 있다고 정리했습니다.
채점하는 AI는 긴 답을 좋아하고, 그 버릇은 쉽게 이용됩니다
이런 길이 편향은 건강 분야만의 이야기가 아닙니다. 스탠퍼드 연구진이 AI 채점 시험인 AlpacaEval을 분석한 연구는 같은 모델에게 프롬프트 한 줄만 바꿔도 점수가 출렁인다는 것을 보여 줬습니다. “최대한 자세히 답하라”와 “필요한 정보는 다 담되 최대한 간결하게 답하라”를 번갈아 주자, 기준 모델의 승률이 22.9%에서 64.3%까지 오갔습니다. 실력은 그대로인데 말투 지시 한 줄로 순위표의 숫자가 크게 달라진 것입니다.
연구진은 답변 길이 차이를 통계적으로 걷어 내는 보정 방식을 제안했고, 보정 뒤에는 같은 모델의 승률 흔들림이 41.9%에서 51.6% 사이로 줄었습니다. 사람들이 직접 투표하는 Chatbot Arena 순위와의 상관도 0.94에서 0.98로 올라갔습니다. 길이를 덜 따지는 채점이 사람의 실제 선호에 더 가까웠다는 뜻입니다. 연구진은 이런 편향이 사람에게는 잘 통하지 않을 방식으로 AI 시스템에 의해 이용될 수 있다고 경고했습니다.
전문가가 고쳐 쓴 답은 짧아졌지만 점수는 지켰습니다
HealthBench 논문에는 더 눈여겨볼 실험이 하나 있습니다. 60개 나라에서 진료 경험을 쌓은 의사 262명이 기준표를 만들었는데, 연구진은 이 중 일부에게 직접 모범 답안을 쓰게 했습니다. 한 무리는 AI 도움 없이, 다른 무리는 2024년 9월 모델의 답변을 참고해, 또 다른 무리는 2025년 4월 모델의 답변을 참고해 고쳐 쓰게 한 것입니다.
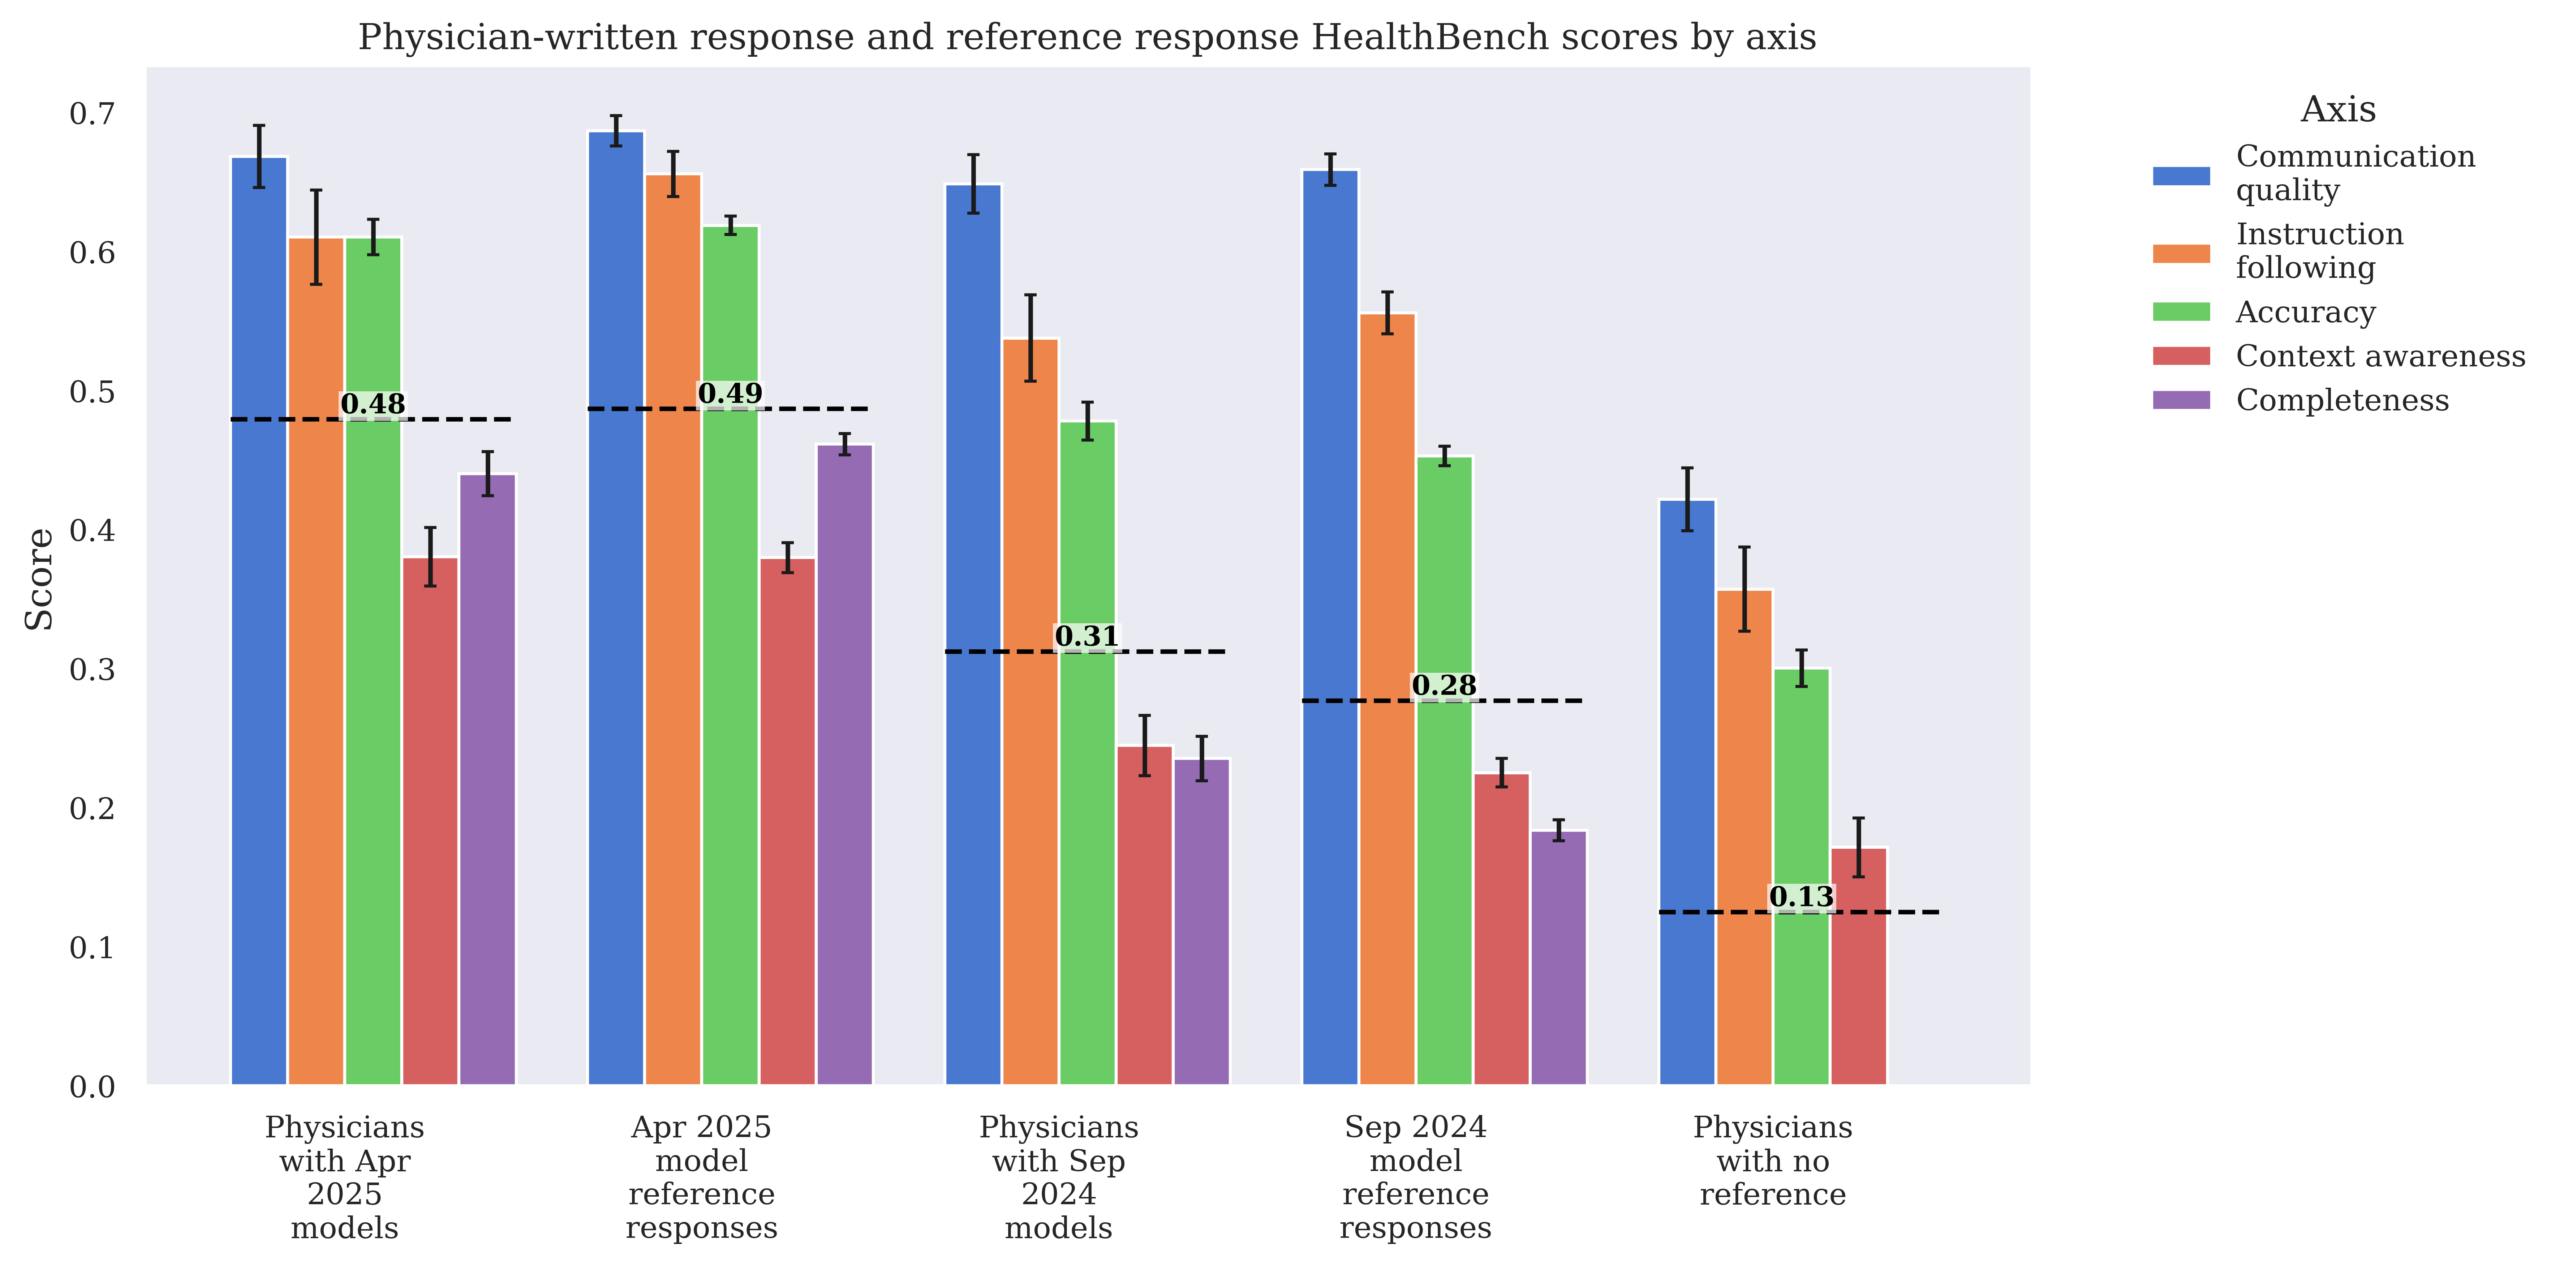
2024년 9월 모델의 답변을 받은 의사들은 원래 답변을 더 낫게 만든 경우가 56.2%, 오히려 나쁘게 만든 경우가 39.8%였습니다. 반면 2025년 4월 모델의 답변을 받았을 때는 나아진 경우가 46.8%, 나빠진 경우가 47.7%로 거의 반반이었습니다. AI가 좋아질수록 전문가가 손대서 더할 수 있는 몫이 줄어든 것입니다. 연구진은 AI 도움 없이 쓴 의사 답변의 점수가 낮았던 이유 중 하나로 답변이 짧았던 점을 들면서, 이 작업이 의사들이 평소 하는 일이 아니라는 점도 함께 짚었습니다.
흥미로운 부분은 길이입니다. 2025년 4월 모델의 참고 답변은 대체로 의사들이 고쳐 쓴 답변보다 길었는데, 두 답변의 점수는 비슷했습니다. 연구진은 의사들이 점수를 유지하면서 답을 간결하게 다듬었다고 해석했습니다. 사업에서 고객 답변을 다루는 방식에도 그대로 옮겨 볼 만한 결과입니다. AI 초안에서 전문가가 할 일은 내용을 덧붙이는 것보다, 빠진 핵심이 없는지 확인하면서 덜어 내는 쪽에 가까워지고 있습니다.
물론 이 결과들은 건강 상담과 일반 지시문이라는 특정 시험에서 나온 것이고, 채점 역시 AI가 맡았습니다. 2,000자라는 기준도 OpenAI가 정한 보정 방식의 값일 뿐, 모든 고객 답변에 맞는 정답 길이는 아닙니다. 그래도 방향은 분명합니다. 우리 서비스에 쓸 AI를 고르거나 상담 답변 프롬프트를 고칠 때, 답변을 다른 AI에게 채점시키는 방식만 믿으면 ‘더 길게 쓴 쪽’을 고르게 되기 쉽습니다. 비교할 때는 길이를 비슷하게 맞추고, 꼭 들어가야 할 항목과 읽기 쉬운지를 나눠서 따로 보는 편이 실제 고객의 판단에 더 가깝습니다.
AI 답변은 길수록 좋아 보이지만, 고객에게 필요한 것은 빠짐없으면서도 짧은 답입니다.
출처와 검증 범위
- 01HealthBench and HealthBench Professional: Evaluating models in realistic health conversations · Artificial Analysis ↗원점수·길이 보정 점수, 평균 답변 길이, 항목별 점수, 비용 대비 점수 확인. 2026-10-19
- 02HealthBench: Evaluating Large Language Models Towards Improved Human Health · Arora 외(OpenAI) ↗평가 설계(의사 262명·60개국), 길이 통제 승률, 의사 작성 답변 실험 확인. 그림 11·15 사용, CC BY 4.0. 2025-05
- 03Length-Controlled AlpacaEval: A Simple Way to Debias Automatic Evaluators · Dubois 외(Stanford) ↗말투 지시에 따른 승률 변화와 길이 보정 뒤 Chatbot Arena 상관 0.94→0.98 확인. 2024-04
- 원문 발표일
- 2026-10-19
- 원문 확인일
- 2026-10-21
- 자료 측정 기간
- HealthBench 논문 2025-05(의사 참여 11개월), AlpacaEval-LC 2024-04, Artificial Analysis 순위표 2026-10-19 공개
- 근거 유형
- 평가 기관 순위표 분석 + 의사 262명이 참여한 벤치마크 논문(길이 통제 비교·의사 답변 실험) + 자동 채점 길이 편향 보정 연구
- 한계·미확인
- 건강 상담·일반 지시문 시험 결과이며 채점도 AI가 맡음. 2,000자 기준은 OpenAI 보정 방식의 값으로 업종별 적정 길이는 아님. 의사 답변 실험은 의사가 평소 하지 않는 작업이라는 단서가 붙음. HealthBench Professional 자체 논문은 확인하지 못함