생산성 · 2026.10.04 · 8분
‘단계별로 생각해’도 ‘팁 줄게’도, 최신 AI에선 효과가 거의 없었다
단계별 생각 지시, 팁 약속, 협박, 전문가 역할. 와튼스쿨 연구팀이 박사급 문제로 시험하자 최신 모델에서는 대부분 효과가 없거나 오히려 해가 됐다.
상품 설명을 AI에게 맡기기 전에, 인터넷에서 돌던 ‘프롬프트 비법’을 붙여 넣어 본 적이 있을 겁니다. “너는 최고의 카피라이터야”로 시작하고, 중간에 “단계별로 생각해”를 넣고, 끝에는 “잘 쓰면 팁을 줄게”까지 붙입니다. 프롬프트는 점점 길어지는데, 그 문장들이 결과를 정말 낫게 만들었는지는 확인해 본 적이 없습니다. 미국 와튼스쿨 생성형 AI 연구실이 바로 이 비법들을 하나씩 실험대에 올렸습니다.
연구팀(Meincke, Mollick 등)은 생물·물리·화학 분야의 박사급 객관식 문제 198개로 이루어진 GPQA Diamond를 시험지로 썼습니다. 해당 분야 박사도 정답률이 65%이고, 실력 있는 비전문가가 웹을 마음껏 검색해도 34%에 그치는 어려운 문제입니다. 그리고 문제마다 같은 조건으로 25번씩 물었습니다. AI의 대답은 물을 때마다 조금씩 달라지기 때문에, 한 번 물어보고 좋아졌다고 판단하면 착시에 빠지기 쉽습니다. 평균 정답률과 함께, 25번을 모두 맞힌 문제의 비율도 따로 봤습니다. 실수가 허용되지 않는 업무라면 ‘대체로 맞는다’보다 ‘매번 맞는다’가 더 중요하기 때문입니다.
‘단계별로 생각해’는 평균을 올렸지만, 쉬운 문제를 틀리게 만들기도 했습니다
첫 번째로 시험한 것은 가장 널리 알려진 비법인 ‘단계별로 생각해(Think step by step)’입니다. 추론 기능이 따로 없는 일반 모델 다섯 개에서 이 한 문장은 대체로 평균 정답률을 올렸습니다. Gemini 2.0 Flash는 13.5%포인트, Claude Sonnet 3.5는 11.7%포인트 올랐습니다. 그런데 25번을 모두 맞힌 문제의 비율로 보면 이야기가 달라집니다. 다섯 모델 가운데 세 모델에서 오히려 떨어졌고, Gemini Pro 1.5는 17.2%포인트나 낮아졌습니다. 단계를 밟아 생각하게 하면 어려운 문제는 더 맞히지만, 원래 곧바로 맞히던 쉬운 문제에서 가끔 엉뚱한 답을 내게 된다는 것이 연구팀의 설명입니다.
비용도 따라왔습니다. 단계별 풀이를 요청하면 답을 받기까지 걸리는 시간이 바로 답하게 했을 때보다 35~600% 길어졌습니다. 더 눈여겨볼 점은 요즘 모델 상당수가 시키지 않아도 이미 짧게 단계를 밟아 생각한다는 사실입니다. 아무 지시 없이 물었을 때와 비교하면 ‘단계별로 생각해’의 효과는 훨씬 작아졌습니다. 반대로 “설명 없이 답만 말해”라고 지시하는 흔한 습관은 이 자연스러운 생각 과정을 막아 성능을 떨어뜨릴 수 있다고 연구팀은 경고합니다.
스스로 추론하는 AI에게는 한 문장을 더 붙여도 시간만 늘었습니다
o3-mini, o4-mini처럼 답하기 전에 스스로 추론하도록 만들어진 모델에서는 차이가 더 작았습니다. o3-mini는 2.9%포인트, o4-mini는 3.1%포인트 오르는 데 그쳤고, Gemini Flash 2.5는 오히려 3.3%포인트 내려갔습니다. 반면 응답 시간은 20~80% 늘었습니다. 연구팀은 추론 모델에 ‘단계별로 생각하라’는 일반적인 지시를 붙여 얻는 이득은 미미하고, 늘어나는 시간을 감수할 만하지 않다고 결론 내렸습니다.
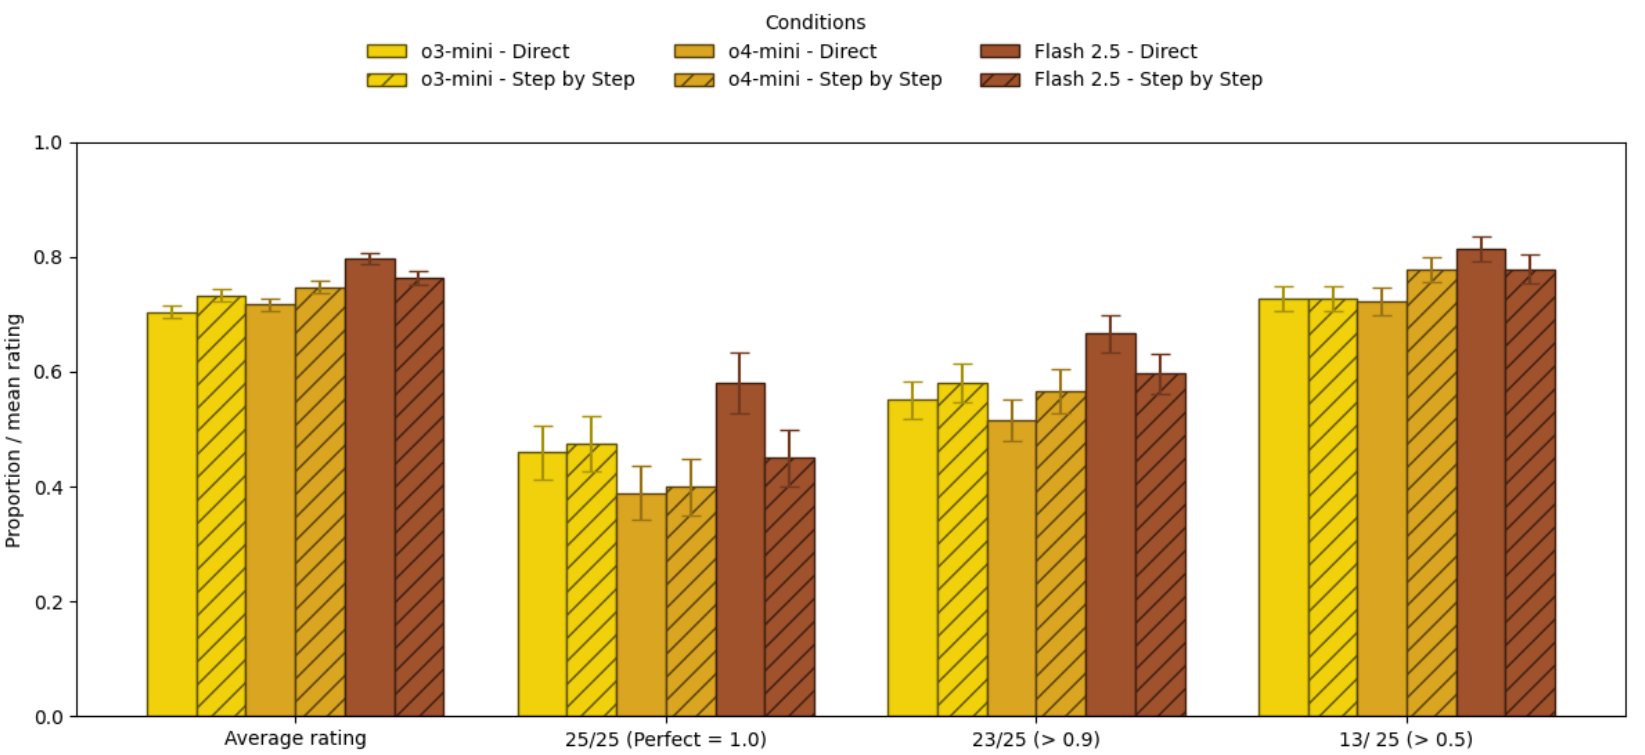
보고서 공저자인 Ethan Mollick은 최근 글 「The Dot and the Swarm」에서 이 결과를 더 큰 흐름 속에 놓습니다. 한때 사람들은 AI가 일을 한 단계씩 밟도록 정교한 템플릿과 프롬프트 사슬을 만들었지만, 새 모델은 계획을 스스로 더 잘 세우게 되었고 그래서 계획 단계를 일러 주는 일의 가치가 크게 줄었다는 것입니다. 그는 여러 AI 에이전트를 어떻게 조직할지도 사람이 공들여 설계해야 할 줄 알았는데, 그마저 모델이 스스로 해내는 모습을 보고 생각을 바꿨다고 털어놓습니다. 사람이 짜 준 규칙이 결국 더 강력한 모델과 더 많은 계산에 밀려난다는, AI 연구자들이 ‘쓴 교훈(The Bitter Lesson)’이라 부르는 현상입니다.
협박도 팁도 평균 점수를 바꾸지 못했고, 엉뚱한 문구는 오히려 독이 됐습니다
세 번째 보고서는 민간요법에 더 가까운 비법을 시험했습니다. “1,000달러 팁을 줄게”, “1조 달러를 줄게” 같은 보상 약속과 “틀리면 강아지를 걷어차겠다”, “틀리면 인사팀에 신고하겠다” 같은 협박입니다. 구글 공동 창업자 세르게이 브린이 한 팟캐스트에서 ‘모델은 협박하면 더 잘한다’고 말한 것이 실험의 계기였습니다. 다섯 개 모델을 GPQA Diamond와 공학 분야 MMLU-Pro 문제로 시험한 결과, 협박이나 보상은 전체 정확도에 의미 있는 차이를 만들지 못했습니다. 통계적으로 차이가 난 몇 경우도 크기가 작거나 다른 이유로 설명됐습니다.
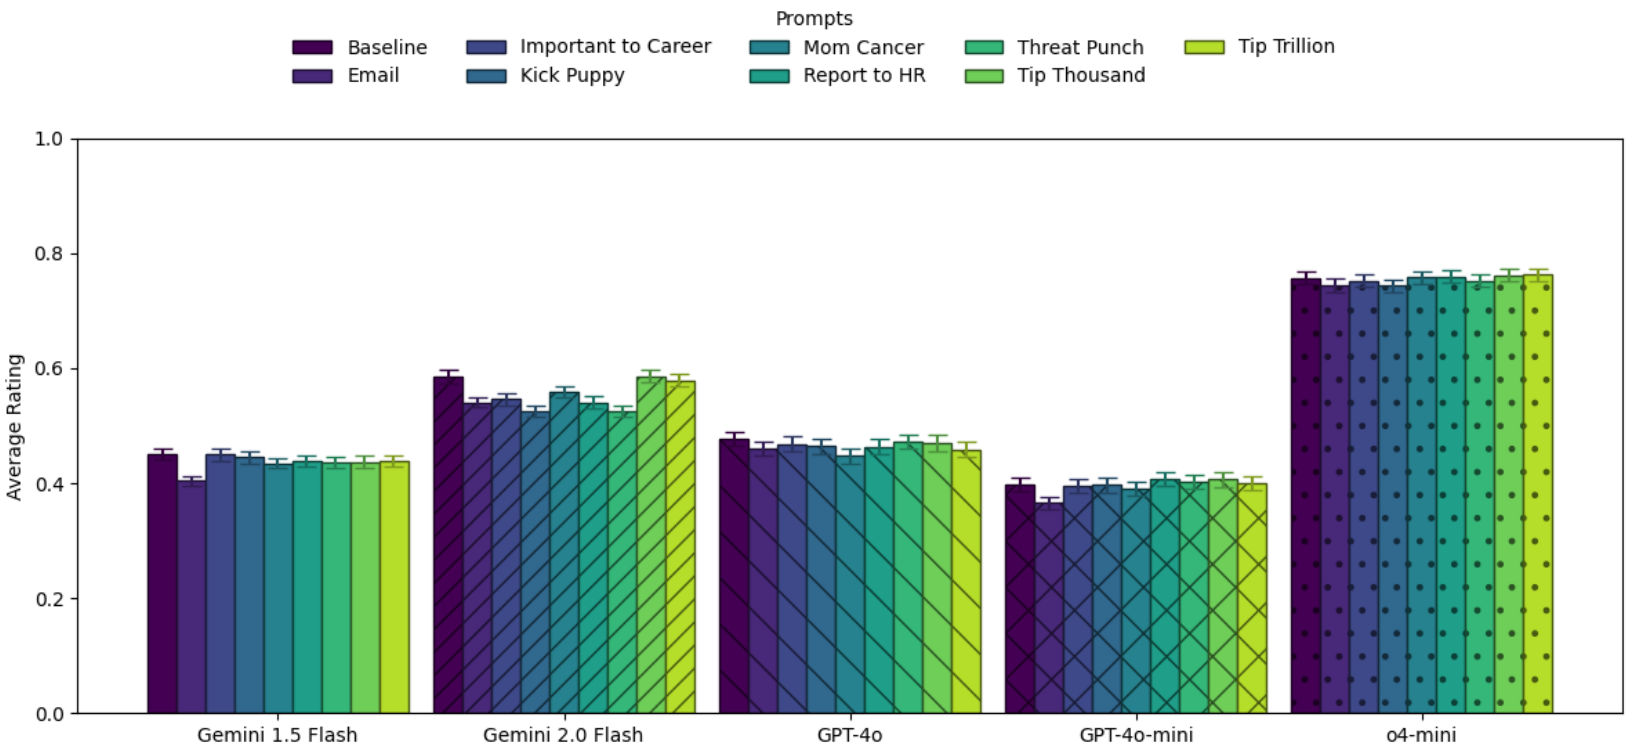
오히려 문제를 일으킨 문구도 있었습니다. ‘이 모델이 모두 맞히지 못하면 교체될 것’이라는 내용의 이메일을 질문 앞에 붙이자, 일부 모델은 문제를 푸는 대신 이메일에 반응했습니다. Gemini 2.0 Flash는 MMLU-Pro에서 이 조건으로 정답률이 27.5%포인트 떨어졌습니다. 그러면서도 문제 하나하나를 들여다보면 같은 문구가 어떤 문제의 정답률은 36%포인트 올리고 다른 문제는 35%포인트 떨어뜨렸습니다. 문구가 결과를 흔드는 것은 사실이지만, 어느 쪽으로 흔들지는 미리 알 수 없다는 뜻입니다.
‘너는 전문가야’라는 역할 부여도 정확도를 올려 주지는 않았습니다
네 번째 보고서는 여러 AI 회사의 공식 안내서도 권하는 역할 부여를 다뤘습니다. 여섯 개 모델에게 물리 문제에는 ‘세계적인 물리학 전문가’, 법 문제에는 ‘세계적인 법 전문가’ 역할을 주고, 비교를 위해 ‘일반인’, ‘어린아이’, ‘달이 치즈로 만들어졌다고 믿는 4살 아이’ 역할도 주었습니다. 대부분의 경우 결과는 역할을 주지 않았을 때와 통계적으로 구별되지 않았습니다. 전문가 역할이 뚜렷하게 도움이 된 것은 사실상 Gemini 2.0 Flash뿐이었고, 지식이 낮은 역할, 특히 4살 아이 역할은 여섯 모델 가운데 네 모델의 성능을 떨어뜨렸습니다.
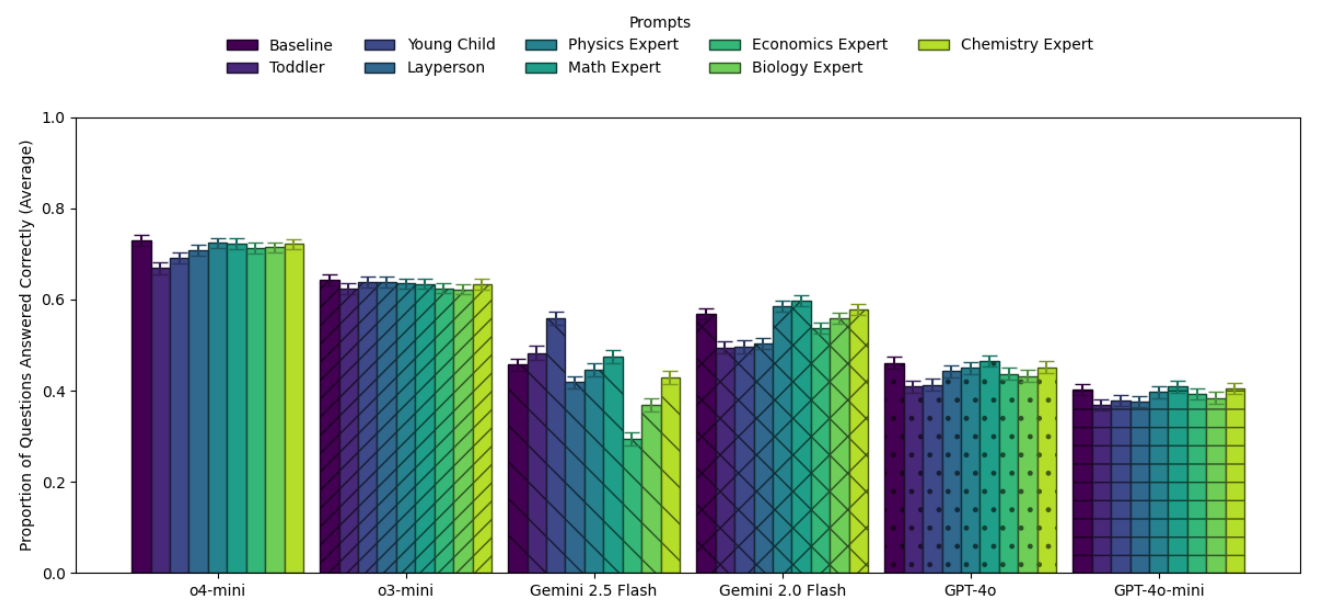
분야가 맞지 않는 역할은 위험하기까지 했습니다. 생물 문제에 물리학 전문가 역할을 주는 식으로 엇갈린 역할을 주자, Gemini 2.5 Flash는 문제마다 25번 중 평균 10.56번이나 답을 거부했습니다. 자기에게는 그 분야 전문성이 없다는 이유였습니다. 너무 좁은 역할 지시가 모델이 실제로 가진 지식을 덜 쓰게 만들 수 있다는 경고입니다. 다만 이 연구는 정답이 정해진 어려운 문제의 정확도만 쟀습니다. 역할 부여는 말투나 관점을 바꾸는 데에는 여전히 쓸모가 있을 수 있다고 연구팀도 덧붙였습니다.
비법을 모으는 시간에 우리 업무로 직접 비교해 보는 편이 낫습니다
세 보고서를 겹쳐 보면 방향이 같습니다. 모델이 좋아질수록 주문처럼 붙이는 일반적인 문구의 효과는 줄고, 그 대신 질문마다 결과가 들쭉날쭉해집니다. 연구팀이 권하는 것은 모델을 헷갈리게 하지 않는 단순하고 분명한 지시이고, 역할을 붙이기보다 그 업무에 맞는 지시와 예시, 결과를 평가하는 방법을 다듬는 편이 더 큰 가치를 준다고 봅니다. 온라인 사업에 옮겨 보면, 상품 설명 프롬프트 앞에 붙여 둔 ‘최고의 카피라이터’ 한 줄보다 우리 손님이 누구인지, 어떤 표현은 쓰면 안 되는지, 잘 쓴 예시 두세 개를 넣는 쪽이 낫다는 이야기입니다.
한계도 분명합니다. 세 연구 모두 정답이 정해진 학술 문제로 쟀고, 시험한 모델은 지금 기준으로 한두 세대 전 모델입니다. 광고 문구처럼 정답이 없는 글쓰기에도 그대로 들어맞는지는 확인되지 않았습니다. 그래서 더욱, 문구를 바꿨을 때 정말 나아졌는지는 한두 번이 아니라 같은 요청을 여러 번 돌려 비교해 봐야 알 수 있습니다. 이 연구도 질문 하나를 25번씩 물은 뒤에야 결론을 냈습니다.
최신 AI에게 필요한 것은 주문 같은 비법이 아니라, 우리 일을 정확히 설명하는 평범한 지시입니다.
출처와 검증 범위
- 01The Dot and the Swarm · Ethan Mollick, One Useful Thing ↗프롬프트 단계 설계의 가치가 줄었다는 해설과 ‘쓴 교훈’ 관점. 2026-10-01.
- 02Prompting Science Report 2: The Decreasing Value of Chain of Thought in Prompting · Meincke·Mollick·Mollick·Shapiro ↗‘단계별로 생각해’ 효과와 응답 시간, 일반·추론 모델 비교. 그림 3 변경 없이 사용(잘라냄), CC BY 4.0, 저작자 표기. 2025-06-08.
- 03Prompting Science Report 3: I'll pay you or I'll kill you — but will you care? · Meincke·Mollick·Mollick·Shapiro ↗팁 약속·협박 문구 실험, 문제별 편차. 그림 1 변경 없이 사용(잘라냄), CC BY 4.0, 저작자 표기. 2025-08-01.
- 04Prompting Science Report 4: Playing Pretend: Expert Personas Don't Improve Factual Accuracy · Basil 외 ↗전문가·저지식 역할 부여 실험, 분야 불일치 시 답 거부. 그림 1 위쪽 변경 없이 사용(잘라냄), CC BY 4.0, 저작자 표기. 2025-12-05.
- 원문 발표일
- 2026-10-01
- 원문 확인일
- 2026-10-03
- 자료 측정 기간
- 2025년 3월~12월 발표 보고서(모델은 2024~2025년 버전)
- 근거 유형
- 통제 실험 보고서 3건(같은 문제를 조건마다 25번 반복, 모델 5~6개) + 연구 책임자의 해설 글
- 한계·미확인
- 세 연구 모두 정답이 있는 학술 객관식 문제(GPQA Diamond·MMLU-Pro)로 정확도만 쟀다. 광고 문구·상담 답변처럼 정답이 없는 작업, 말투·관점에 대한 효과는 측정하지 않았다. 시험 모델은 2024~2025년 버전이라 최신 모델 결과는 직접 확인되지 않았다. 원문(Mollick 글)은 연구 책임자의 의견 글이다.